案例 · 古典梵语 · 汉文佛典 / 文献工具
溯梵(SuFan) · 佛典对读与诵读
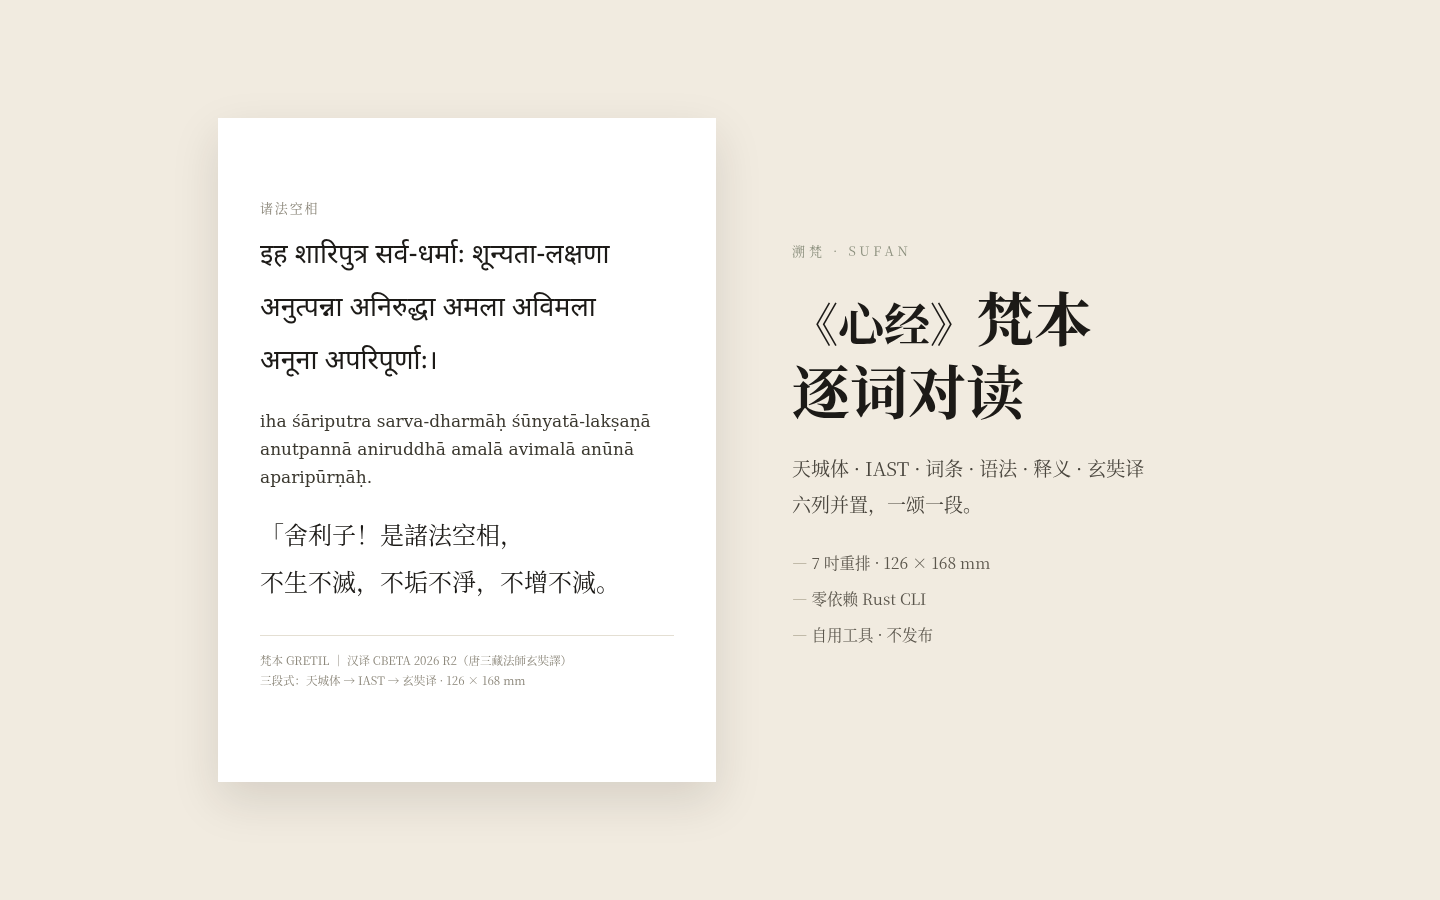
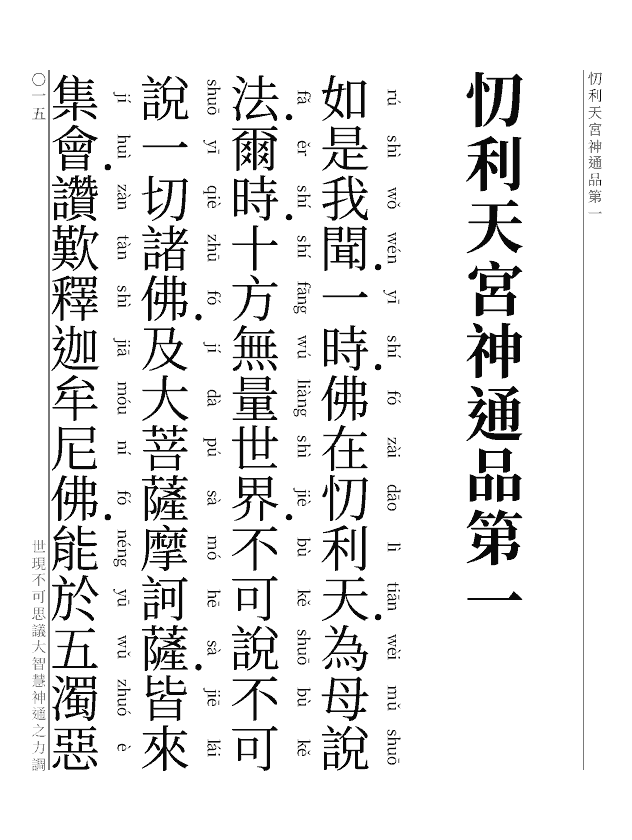
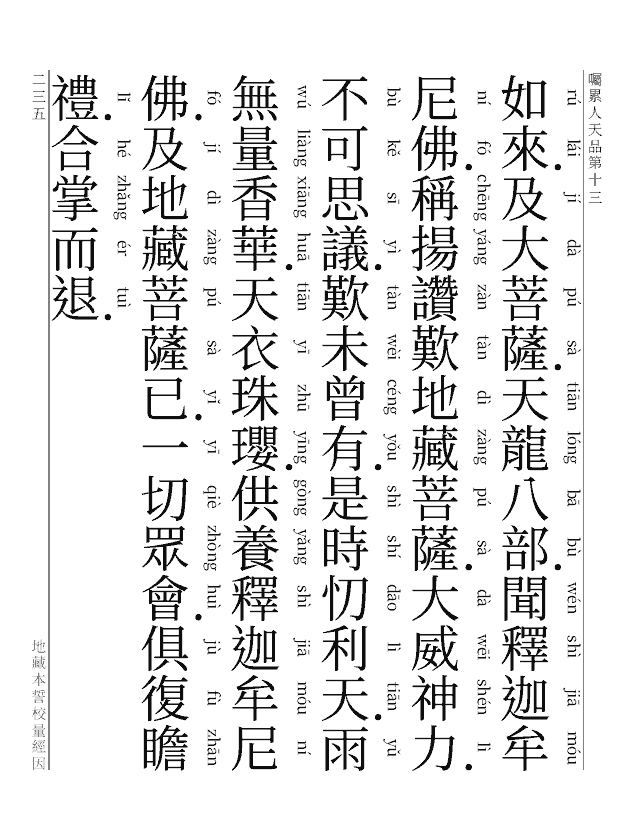
一件自用的佛典工具,两条线:《心经》梵本拆到词、与玄奘译六列并置;《地藏经》校成一字不缺的正文,排成 240 页竖排大字诵读本,供 7 吋电子墨水屏诵读。为它做的不只是命令行 —— 还有一套屏幕排版参数、九条真言的三层对照,以及一份逐文件的许可台账。
背景
之水自有产品里的一件自用工具。两条线各有一个具体的读者动作:
- 逐词对读:业主在学古典梵语,每周 2–3 小时,锚点是两年内逐词读完《心经》梵本(
Prajñāpāramitā-hṛdaya)。 - 诵读本:同一双手要在 Kindle 上把《地藏菩萨本愿经》读完 —— 纸本三卷、字小、没有注音,句读挤在字缝里。
读完一颂要重复四件事:拆连声、把词还原成词条、查词典、和玄奘译对上。手上要同时摊开底本、转写、词典、语法与汉译 —— 在四五个窗口之间来回跳,读三颂就断了。
溯梵解决的不是“缺一个梵语阅读器”,而是“同一篇文本的六个面没有一处能并排放”;第二件事解决的不是“缺一个读经 App”,而是“没有一种版式让长经读得下去”。
挑战
- 天城体在 PDF 里是图形,排错就永远是错的。 连写(
saṃyoga)把辅音叠起来,字形一旦被拆开或裁切,读者只会怪教材。而目标是 7 吋电子墨水屏:正文不小于 11pt、天城体行距还要加宽。 - 汉文佛典的敌人是“静默丢字”。 转写底本里被模板吞掉的字不会报警,只会消失 —— 第一版 EPUB 就漏了 24 字。所以做了一条门禁:每卷汉字数与基线精确相等,被模板吞过的 18 个字形逐个计数,不等就拒绝出书。
- 注音会抢版面。 拼音贴在竖排字右侧,必须占真实宽度;不把栏距抬到 1.8 字身,注音就会压进隔壁栏 —— 这是试印时真的发生过的。
- 咒语的“梵本”常常不存在。 九条真言里有三条是汉地梦授咒,原文即汉文,梵语世界里没有它的原典。追本子之前先判材料成色:能分段对齐的才是本子,只能整句读的只是“别人的念法”。
- 许可要逐文件核实。 切分引擎不在 crates.io 上、仓库根也没有 LICENSE 文件;两个底本用不同的 CC 条款;教材站点的新旧版许可还不一致。做之前先读许可,读完把结论写进产物 —— 否则将来连自己都不敢再用。
- 第三方文本不能变成公开分发物。 读本与逐词表含 CC BY-NC-SA 的底本文本。为一个自用工具去承担衍生品分发,不划算 —— 所以这个站只放自己产出的排版截图。
- 教材在 7 吋屏上不能用。 官方版是 462 页 A4;重排时才发现,教材站点的响应式写在
@media screen里 —— 打印时那条媒体规则永不生效,34pt 的字母块把五个元音撑成三页。
交付
- 一个零依赖 Rust CLI:六列校订稿 → Markdown 逐词表;另一条命令统计词界的连声类型。实测 118 处词界后发现,元音连声加
visarga只占 16.1%,大头在辅音侧 —— 这条数据直接改掉了“先学两类就够读”的经验判断。 - 一套 7 吋排版参数:126 × 168 mm、正文 11pt、天城体 14pt。先出一份 3 页样张,在同款设备上验收通过,参数才固定下来。
- 《地藏经》诵读本(240 页):107 × 142.2 mm,正文 24pt,每栏 14 字、每页 6 栏;无标点、逐字注音、句读点在字左侧(不占字符格),夹注按字数决定单列还是双列;封面按古籍内封重做(经名大字居右、译者小字在左且低两格);纸本的「卷上/中/下」标示按电子版删去,只留换页与书签。九条真言排成梵文 · 罗马音 · 中文三层,凡对音重建的当场标明,不冒充梵本。
- 三份读物:梵汉对照读本(7 页,按内容分七段硬对齐)、学习路径(7 页,含教材页码对照)、主教材 582 页重排版(带目录、章页码与 PDF 书签)。
- 一份许可台账:每份产物的来源、版本、抓取日期与改动说明,逐条印在各自的版本页上。诵读本的正文是公有领域(大正藏 T13 no.412),可与读本的 CC BY-NC-SA 分线写。
结果
两条线都在手上跑起来:第一个真实段落「行深」有 17 行逐词校订稿,校订稿 → 表的链路端到端跑通;读本与学习路径已进阅读器,按周次开始用;诵读本全书 240 页、字体零回退、九项门禁全绿,已在 Kindle Oasis 上通读。
它仍然是一件自用工具:不销售、不发布。这个站存在的理由只有两个 —— 说明它在做什么,以及把排版与许可这两件事的成果摆出来给人看。站上能下的只有一样东西:诵读本的 PDF(正文公有领域、注音与版式是我们做的);其余四份含第三方文本,只放页图。